28 septembre 2026
ax : le Kubernetes des agents IA signé Google
Google a ouvert ax, orchestrateur d'agents IA sur Kubernetes, au-dessus d'Agent Substrate. Docs, code et issues lus : l'idée tient, le quickstart casse.

15 min de lecture
La démo qui tourne en boucle sur agentexecutor.io tient dans un terminal animé : on applique un manifeste, on compile Go dans le sandbox via ax ssh, on crée un fichier, on suspend la tâche, on la reprend, le fichier est toujours là. Ce texte qui défile a suffi à envoyer google/ax à 666 points et 299 commentaires sur Hacker News le 20 septembre 2026, le jour même de la v0.3.0. Le dépôt, lui, est ouvert depuis le 30 mars et en est à v0.3.1, taguée le 25 septembre.
J'ai lu le README, DESIGN.md, les huit pages de docs, les exemples, le dépôt frère agent-substrate/substrate, et surtout les issues. Le projet est plus intéressant que la démo, et plus immature que le site vitrine. Les deux méritent d'être écrits noir sur blanc.
À retenir
axest un orchestrateur open source (Apache-2.0, Go, ~12 500 étoiles au 29 septembre 2026) : il exécute des tâches d'agents sur Kubernetes, au-dessus d'Agent Substrate.- Il n'orchestre pas le raisonnement, il orchestre des tâches longue durée : suspension avec checkpoint, reprise, shell dans le sandbox, workspace préparé d'avance.
- Le backend, Agent Substrate, revendique ~250 acteurs à état multiplexés sur 8 pods et des reprises sous 500 ms. Chiffres du README, que je n'ai pas reproduits.
- L'architecture assume un choix clivant : l'état vit dans Redis, pas dans des CRDs Kubernetes, et elle a encore changé le 27 septembre.
- Le quickstart ne fonctionne pas tel quel : image par défaut en 403, pas de
WorkerPool, clones git bloqués par l'egress. Et une faille critique d'authentification du plan de contrôle est ouverte.
ax sur Kubernetes : le plan de contrôle des agents, sans etcd
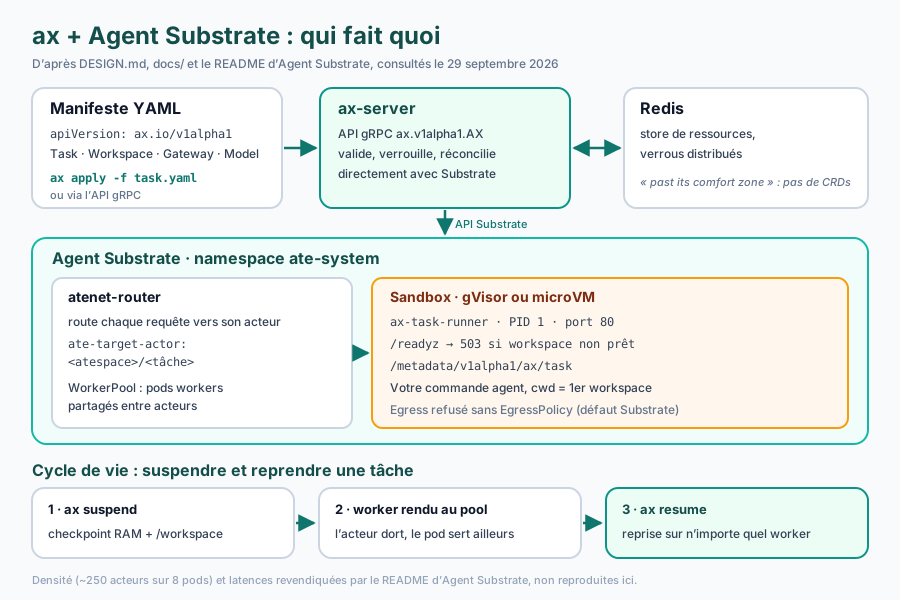
ax tient en trois binaires. Le CLI, d'abord, « deliberately kubectl-shaped » selon le README : apply, get, describe, watch, delete, plus les verbes métier ax suspend task task123, ax resume task task123 et ax ssh task123. Le serveur ensuite, ax-server, une API gRPC que le CLI atteint en suivant votre contexte kube courant : kubectx prod-cluster && ax get tasks fonctionne, ax ctx explique comment. Et ax-task-runner enfin, le PID 1 de chaque conteneur de tâche.
Le plus parlant pour un ingénieur infra, c'est la première phrase de DESIGN.md :
Storing millions of short-lived tasks as Kubernetes CRDs pushes etcd past its comfort zone (single-digit GB storage limits, write-rate bottlenecks, control plane degradation). AX stores its state in Redis and reconciles directly with Agent Substrate under fine-grained distributed locks.
Traduction : pas de Custom Resource Definitions, donc pas de kubectl get tasks. L'état vit dans Redis, protégé par des verrous distribués. Conséquence directe : ce que Kubernetes donne gratuitement aux CRDs (RBAC, quotas de namespace, webhooks d'admission) ne s'applique pas aux objets ax. Il faut tout refaire côté ax-server, et c'est précisément là que le projet a son trou le plus grave (j'y reviens).
Autre signe de jeunesse : cette architecture a bougé pendant que j'écrivais. Le commit ac23328 du 27 septembre, postérieur à la v0.3.1, supprime la file Redis Streams et le binaire ax-controller pour une réconciliation synchrone dans ax-server. Certaines issues décrivent déjà du code disparu : le fil de la #376 le constate pour UpdateTask.
Le ton est donné par le bandeau du README, à lire avant tout le reste : « AX and several of its features are in heavy development. We are actively refining our core concepts, protocols, and specifications, and will likely introduce major breaking changes prior to a stable release. » Et la note de la toute première release, v0.1.0 du 20 mai, dit pourquoi le projet existe : « We are releasing this early stage to be able to have some concrete conversations. [...] This enables those who want to run the agentic session and extensions on their own data plane. »
Agent Substrate, l'étage du dessous : 250 acteurs sur 8 pods
ax délègue l'exécution à Agent Substrate, un runtime qui « maps a larger set of actors onto a smaller set of ready workers ». Le pari est simple : un agent passe l'essentiel de son temps à attendre (le modèle, un outil, un humain), donc on peut en empiler beaucoup sur peu de pods, à condition de savoir les endormir et les réveiller vite.
Trois composants dans le namespace ate-system (quand ax vit dans ax-system) : atenet-router route le trafic vers le bon acteur via l'en-tête ate-target-actor: <atespace>/<actor> ; atelet, un DaemonSet par nœud, supervise les pods workers et coordonne les snapshots ; ateom tourne dans chaque pod worker et pilote le sandbox, gVisor (runsc checkpoint/restore) ou microVM cloud-hypervisor. Les workers sont regroupés dans des WorkerPool, eux bien en CRD Kubernetes.
Ce que le README de Substrate revendique : une densité « 10x higher than standard container runtimes », des reprises « sub-500ms » à plus de 500 activations par seconde, et, dans la vidéo de lancement, ~250 acteurs à état multiplexés sur 8 pods, soit un surabonnement de plus de 30 pour 1. Le README ne détaille pas comment ces chiffres ont été mesurés, et je n'en ai reproduit aucun.
L'axolotl n'est pas là pour faire joli : c'est la mascotte officielle d'ax, en tête du README. Le choix est bien vu, l'animal est connu pour régénérer ses membres, et un acteur Substrate fait à peu près la même chose en repartant de son snapshot.
Deux détails à connaître avant d'y mettre un agent. D'abord l'identité : plusieurs acteurs se succèdent sur un même pod, donc l'identité du pod ne dit plus qui parle. C'est exactement l'objection qui fâche sur Hacker News (plus bas). Ensuite la provenance : Substrate vit hors de l'organisation google (3 900 étoiles, ~340 issues ouvertes au 29 septembre 2026), et sa candidature au Sandbox de la CNCF est marquée comme votée. Un contributeur, ahmedtd, précisait sur Hacker News que l'organisation « is currently Google's, but that will change ».
Quatre ressources et un runner : le contrat qu'on signe
Le format de manifeste est ce que le projet a de plus réussi. Le README parle de trois ressources, Task, Workspace et Model ; le site en affiche quatre avec Gateway, qui décrit la liste blanche réseau d'une tâche. Le squelette ci-dessous reprend examples/task.yaml, allégé.
apiVersion: ax.io/v1alpha1
kind: Task
metadata:
  name: task123
  atespace: default
spec:
  resources:
    limits:
      cpu: "2"
      memory: "4Gi"
  workspaces:
    - name: default-workspace
      path: "/workspace"
  debug: true   # sert les services invités, sinon ax ssh refuse
---
apiVersion: ax.io/v1alpha1
kind: Workspace
metadata:
  name: default-workspace
  atespace: default
spec:
  git:
    - name: origin
      repo: "https://github.com/chalk/chalk.git"
      branch: "main"
---
apiVersion: ax.io/v1alpha1
kind: Model
metadata:
  name: default-model
  atespace: default
spec:
  provider: google
  model: gemini-3.8-flash
  secretKey:
    name: gemini-api-secret
    key: GEMINI_API_KEY
Un Workspace liste ce que l'agent doit trouver en démarrant : dépôts git, serveurs MCP, paquets de skills. Il peut même être décrit par un objectif en langage naturel (goal: "Ensure that Go tool chain is available...") que la plateforme prépare elle-même. C'est la clé du système : la tâche n'est pas son pod, son environnement lui survit.
Le Model est la ressource la plus mal comprise, y compris par moi à la première lecture. Il ne configure pas le modèle de votre agent : le README précise qu'il configure « which LLM the platform itself uses », c'est-à-dire le modèle qui sert aux fonctions génératives d'ax, comme la préparation d'un workspace à partir d'un goal. Votre agent garde son propre SDK et sa propre clé. Et aujourd'hui, seul le fournisseur google est implémenté : la doc montre un exemple provider: anthropic qui est accepté puis échoue à l'usage (#371).
En face, le runner impose un contrat minimal, décrit dans docs/runner.md et docs/sandbox.md : votre binaire devient PID 1, sert HTTP sur le port 80, expose un /readyz qui renvoie 503 tant que le workspace n'est pas prêt, et publie la définition de la tâche sur /metadata/v1alpha1/ax/task. Il doit rester vivant après la fin de la commande, sinon ax ssh ne répond plus. Pour le debug, ax ssh ouvre un shell dans le sandbox à condition d'avoir debug: true : ces services invités permettent d'exécuter n'importe quoi dans le sandbox, d'où l'opt-in.
Ce qui casse vraiment quand on essaie ax
Voilà la partie que je cherchais en ouvrant le dépôt : les issues décrivent le quickstart en échec, avec les messages exacts. Toutes celles-ci étaient ouvertes au 29 septembre 2026.
- L'image par défaut n'est pas publique (#424).
gcr.io/ax-substrate/ate-images/ax-task-runner, utilisée par les exemples etdemo.sh, renvoie403 Forbiddenen accès anonyme. Toute tâche sansspec.imageéchoue hors de Google ; il faut construire l'image soi-même. - Aucun
WorkerPooln'est créé (#437). Sans pool, la première tâche échoue enResourceExhausted desc = no free workers available, et resteFailedmême après l'ajout d'un pool (#367). L'auteur de l'issue fournit un manifeste de contournement. - Les clones git échouent en silence (#427). Substrate prépare le workspace pendant un démarrage « golden » dont l'egress est bloqué par défaut ; le
git cloneéchoue et la tâche affiche quand mêmeWorkspaceReady. - Le README montre
Running, la tâche démarreSuspended(#426). Il faut unax resumejuste aprèsax apply, étape que le README ne montre pas et quedemo.shfait. - Les snapshots pointent vers un bucket de test Google (#372),
gs://snapshot-substrate-test-ax-substrate/, sauf à connaître une variable d'environnement non documentée. Etmake deployne produit que des imageslinux/amd64(#358), ce qui casse un cluster ARM.
Deux issues de sécurité complètent le tableau. La #376, signalée au programme de récompense open source de Google qui l'a classée « valid critical product vulnerability » : ax-server n'a ni authentification ni autorisation, et le tenant est un simple champ de la requête, donc tout client qui joint le serveur lit ou supprime les tâches de tous les tenants. Le fil a depuis nuancé un point (la joignabilité depuis un sandbox n'est plus vraie sur main), pas le fond. La #363 décrit une exécution de commande via une branche git commençant par --upload-pack=, injectée telle quelle dans git fetch.
Ajoutez un mur de gouvernance : la politique de création de pull request du dépôt est collaborators_only. On peut ouvrir une issue et discuter, mais pas proposer un correctif depuis un fork ; l'auteur de la #358 le dit en toutes lettres, correctif prêt sur sa branche. Ce n'est pas un bug, c'est un choix, et il annonce le niveau de contribution externe que le projet accepte aujourd'hui.
Ce que Hacker News reproche à ax en 299 commentaires
Le fil du 20 septembre vaut plus qu'une keynote parce qu'il tape sur un seul point : l'écart entre le pitch et le chemin d'installation. alembic_fumes met côte à côte le « uncompromising focus on ergonomics, rapid iteration, and joyful workflows » du site et les prérequis du quickstart (un cluster Kubernetes, ko, un registry joignable depuis le cluster, une API Substrate joignable), avant de conclure : « there's a vast chasm between what this tool is being sold as and what it actually is ». Un admin Kubernetes lui répond que créer un cluster tient désormais en « literally one command ».
weedfroglozenge enfonce la démo : « Nobody has a use for this [...] Even the demo gif playing just has them pausing a task and resuming the task. » imtringued se moque de docs/concepts.md, qui disait alors « A Model is not a model » ; l'issue #356 proposait de renommer la ressource ModelInstanceConfiguration. Elle est close, la ressource s'appelle toujours Model, et la phrase a disparu de la doc.
La réponse utile vient de rakyll, qui se présente comme « one of the co-creators of this project » et dit travailler sur Kubernetes : « We met quite a large number of customers in the last few months, and several teams inside Google, who are asking for a stack that runs on any cluster. » Trois raisons suivent. La première : « it's extremely hard to deliver large agentic applications to someone else's compute ». La troisième, la plus parlante pour une PME : les clients veulent « a truly transparent stack for compliance/auditing ». C'est le vrai positionnement d'ax : pas un framework d'agent, un format de livraison, pensé pour tourner sur le compute de quelqu'un d'autre.
Reste l'objection qui compte chez ceux qui déploient. hhh, en environnement d'entreprise : « I don't really like the oversubscription of agent pods though, as you can no longer trust the k8s pod identity as being from a singular workload. Haven't seen a solution to this for ax yet and it is a barrier to adoption for us. » ahmedtd répond que Substrate devient un fournisseur d'identité OIDC et SPIFFE, et que l'identité de l'acteur sera injectée dans les requêtes sortantes par la passerelle egress : « This is work in flight, but it will land within a few weeks ». La roadmap d'ax liste de son côté des identités SPIFFE par tâche.
Côté confiance, fg137 résume l'objection culturelle : « Google's open source project are not any more trustworthy than a one man's project in terms of support and maintainability », et un autre commentateur renvoie à killedbygoogle.com. Le dépôt a six mois et sa dernière release date du 25 septembre : l'histoire ne dit encore rien, et c'est déjà une information.
Faut-il y toucher ?
Trois cas de figure, une réponse dans chacun.
Vous bricolez un agent pour vous, ou pour un client en SaaS où vous contrôlez l'infrastructure : non. Une file de jobs et un conteneur suffisent ; ax vous ajouterait un cluster, Redis, un registry et deux dépôts à suivre. Le vrai risque de ce genre d'agent est ailleurs, dans la boucle qui tourne sans surveillance, comme le raconte la technique « Ralph Wiggum ».
Vous devez livrer votre agent dans le cluster de votre client, ou lancer des centaines d'agents isolés à la demande : c'est exactement le problème que le projet s'attaque à résoudre. La densité annoncée par Substrate joue alors plus sur le coût par agent qu'une optimisation de prompt, et la question de l'hébergement rejoint celle de la souveraineté des données. Mais pas avant que la #376 soit corrigée.
Vous cherchez un framework d'agents : vous êtes au mauvais étage. ax ne raisonne pas, il exécute. Il est complémentaire d'un LangGraph, d'un ADK ou d'un agent maison, pas concurrent.
Plan d'action
- Lisez les issues avant le tutoriel. Filtrez sur les issues ouvertes de
google/axet lisez au minimum #376, #424, #427 et #437 : elles décrivent les murs que vous allez prendre, avec leurs contournements. - Montez un bac à sable jetable. Cluster Kind via les scripts
hack/de Substrate, jamais un cluster partagé : tant que la #376 est ouverte, quiconque jointax-servervoit tous les tenants. - Construisez vos images vous-même.
make push-task-runnerpour le runner (#424), en ciblant l'architecture de vos nœuds (#358), et renseignezAX_SNAPSHOTS_BUCKETvers votre propre stockage (#372). - Créez un
WorkerPoolavant la première tâche, avec le labelate.dev/substrate-versionde vos nœuds, en partant du manifeste donné dans la #437. - Vérifiez que le workspace est réellement cloné (
ax ssh <tâche> -- ls /workspace) au lieu de croireWorkspaceReady. La #427 n'a pas de contournement simple : la politique d'egress d'une tâche ne s'applique pas au démarrage « golden » qui clone le dépôt. - Lisez
docs/runner.mdsi vous packagez votre agent : c'est le seul contrat stable du projet, le reste bouge d'un commit à l'autre. - Revenez dans quelques mois. Surveillez la correction de la #376, l'identité par acteur annoncée côté Substrate et l'entrée effective à la CNCF. Ce sont les trois signaux qui rendront la question « production » sérieuse.
ax est la réponse la plus sérieuse à une question que tout le monde pose et que personne n'arbitre : où vit un agent entre deux tours de boucle. Le diagnostic est juste, l'architecture est courageuse, Redis ou pas, et le produit est à plusieurs versions de la sérénité. Ouvrez les issues avant le tutoriel, vous gagnerez une soirée.
Vous voulez cadrer un agent IA sur votre propre infrastructure, sans parier sur un runtime en v0.3 ? On en discute.
Questions fréquentes
Les réponses courtes aux questions que ces sujets soulèvent le plus souvent.
 Franck Boué · 11 min